Lagebericht vom Mittwochabend, 21. Oktober 2026, mit Updates vom Donnerstagmorgen am Ende der Abschnitte. Es fing am Mittag damit an, dass die Webseite der Stadt Mainz nicht mehr aufging, kurz darauf war die Charité weg, dann meldete Mittwald, dass sämtliche Kundenwebseiten des Hosters offline seien, in den Niederlanden schaltete die Regierung DigiD und MijnOverheid ab, Kanadas Regierung nahm Bundeswebseiten vom Netz, und in Japan sperrte Square Enix die Logins zu Final Fantasy XIV. Schuld ist kein Angriff, sondern zwei Lücken im Kern von PHP, die den Namen PHP2Shell bekommen haben und praktisch jede PHP-Installation der letzten zehn Jahre betreffen, also jedes WordPress, jedes TYPO3, jede Nextcloud und obendrein etliche Firewalls und NAS-Geräte. Da bei mir mehrere WordPress-Seiten in Docker auf einem VPS laufen, habe ich den Tag damit verbracht, die Lage zu verfolgen, meine Server auf den neuen Stand zu bringen und Statusseiten, Behördenwarnungen und Liveblogs quer durch Europa zu lesen. Hier ist, was ich zusammengetragen habe: Was die Lücke ist, wie sie gefunden wurde, wer vorsorglich abgeschaltet hat, welche Hoster schon gepatcht haben, ob schon angegriffen wird und was Ihr jetzt tun müsst.
Was ist PHP2Shell eigentlich?
Hinter dem Namen stecken zwei Schwachstellen, CVE-2026-109618 und CVE-2026-109619, die das PHP-Security-Team beide mit 9,2 von 10 Punkten nach CVSS 4.0 bewertet. Beide erlauben es einem Angreifer, ohne Anmeldung eigenen Code auf dem Webserver auszuführen, und zwar nicht wegen eines Fehlers in WordPress, Joomla oder einem Plugin, sondern weil PHP selbst beim Aufräumen nach einem abgebrochenen Request schlampt. Der Name ist eine Anspielung auf Log4Shell vom Dezember 2021, und so übertrieben ist der Vergleich leider nicht.
Vereinfacht gesagt passiert Folgendes: Wenn ein PHP-Request unerwartet abbricht, bspw. weil er an das memory_limit stößt oder in einen fatalen Fehler läuft, bleibt im PHP-Worker interner Zustand liegen, den der nächste Request desselben Workers weiterverwendet, obwohl der zugehörige Speicher längst freigegeben oder nur halb initialisiert ist. Ein Angreifer provoziert also gezielt so einen Abbruch, bspw. mit einem präparierten Upload-Formular oder absurd tief verschachtelten Feldnamen, und schickt dann einen zweiten Request hinterher, der den liegengebliebenen Zustand ausnutzt. Das Perfide an der ersten Lücke ist, dass der Fehler schon beim Einlesen des Requests passiert, also bevor auch nur eine Zeile Anwendungscode läuft, weshalb es egal ist, ob dahinter ein frisches WordPress oder ein simples „Hello World“ steht. Die Forscher von Wiz haben insgesamt vier Wege im PHP-Kern gefunden, unter anderem in der Fortschrittsanzeige für Datei-Uploads (session.upload_progress, standardmäßig aktiv), in der Backtrace-Erzeugung bei fatalen Fehlern und im OPcache, und damit Codeausführung gegen die aktuellen Docker-Images von WordPress, Drupal und Joomla demonstriert.
| Lücke | Was passiert | Besonderheit |
|---|---|---|
| CVE-2026-109618 (OOM-Korruption) | Beim Erreichen des Speicherlimits bricht PHP mitten in der Initialisierung ab, die Bereinigung hält den kaputten Zustand für gültig | Ein einziger unauthentifizierter Request reicht, noch bevor Anwendungscode läuft; gegen Apache mit mod_php über HTTP mit Standardeinstellungen bestätigt |
| CVE-2026-109619 (veralteter globaler Zustand) | Request-Daten überleben die Freigabe und werden vom nächsten Request desselben Workers benutzt | Mindestens zwei Requests nötig, erst Fehlerzustand erzeugen, dann ausnutzen; über den Upload-Progress-Pfad sowohl gegen mod_php als auch gegen PHP-FPM bestätigt |
Warum stuft das PHP-Team Apache mit mod_php als am riskantesten ein? Weil mod_php nach so einem Abbruch den Worker einfach weiterverwendet, während PHP-FPM den Worker-Prozess beendet und damit den kaputten Zustand wegwirft. Ganz aus dem Schneider ist FPM damit aber nicht, denn die zweite Lücke wurde laut PHP Foundation auch gegen FPM bestätigt, über Codepfade in der Anwendung. Das Advisory rät FPM-Betreibern deshalb, pm.max_requests=1 in Erwägung zu ziehen, damit zwei Requests nicht mehr denselben Worker treffen können. Betroffen sind laut PHP-Team alle Installationen, die Web-Requests beantworten, also mod_php, PHP-FPM, php-cgi, FrankenPHP und LiteSpeed, laut heise ausdrücklich auch PHP unter Windows, und laut Wiz jede Version seit PHP 5.4. Der Fix selbst ist ein Brocken: Der Commit „Avoid state corruption via bailout“ ändert 423 Dateien mit über 11.000 neuen Zeilen, weil PHP den Abbruch bei Speichermangel grundlegend anders behandeln muss.
Wie groß ist das Problem?
Laut W3Techs läuft PHP auf 69,3 Prozent aller Webseiten, deren serverseitige Sprache bekannt ist, Stand 21. Oktober. Von diesen PHP-Seiten laufen 65,2 Prozent auf PHP 8, aber 27 Prozent noch auf PHP 7 und 7,7 Prozent auf PHP 5, also gut ein Drittel auf Versionen, für die es gar keine offiziellen Releases mehr gibt. Cisco Talos schätzt deshalb, dass rund die Hälfte aller PHP-Systeme keinen Patch bekommen wird. Censys zählt laut KrebsOnSecurity 2,58 Millionen direkt aus dem Internet erreichbare Hosts mit PHP und 54,9 Millionen Web-Properties, die PHP ausliefern. Das ist die Größenordnung, über die wir hier reden, und das erklärt, warum von Helsinki bis Tokio die Wartungsseiten hochgingen.
Die Zeitlinie: Zwei Jahre, ein Leak und ein Mittwoch im Ausnahmezustand
Die PHP Foundation hat am Mittwochabend einen bemerkenswert offenen Blogbeitrag veröffentlicht, aus dem sich die Vorgeschichte rekonstruieren lässt. Die erste Spur des Speicherfehlers tauchte demnach schon 2024 bei einem externen Audit von Quarkslab auf, das die Sovereign Tech Agency über OSTIF finanziert hatte, eine Ausnutzbarkeit konnte damals aber nicht bestätigt werden. Am 30. Juli 2026 begann die Firma Calif im Rahmen des Programms „Patch the Planet“ ein Audit, am 11. August meldete sie eine Codeausführung ohne Vorbedingungen mit genau dieser Ursache, und am selben Tag meldete OpenAI unabhängig davon dieselbe Ursache. Am 24. August lieferte Wiz weitere Angriffswege nach, am 18. September noch einmal OpenAI. Die Foundation räumt ein, dass die lange Zeit bis zum Fix „a structural failure, caused by both the security team’s decision process and its lack of resources“ war, und kündigt an, dass das Security-Team künftig per Mehrheit entscheidet, die Führung bei festgefahrenen Diskussionen früher eingreift und dass man um dauerhafte Finanzierung durch Hoster, Cloud-Anbieter und öffentliche Stellen bittet. Zur Rolle der KI heißt es ausdrücklich: „a person makes every call and works on every patch.“ Wiz formuliert es so: Die Fehler seien seit Jahrzehnten im Code gewesen, ihre Ausnutzung habe aber eine extrem komplexe Kette erfordert, und „Frontier AI models substantially reduced that barrier, turning a longstanding flaw into an exploit.“ In den Credits stehen neben Calif, Wiz, OpenAI und Quarkslab auch Alpha-Omega, die Sovereign Tech Agency und Anthropic.
Eigentlich sollte der Patch am Donnerstag, dem 22. Oktober, erscheinen. Dann ging es am Montag los: Gegen 17 Uhr unserer Zeit kursierten die CVE-Nummern in Foren und sozialen Netzwerken, versehen mit einem falschen Termin und einem falschen CVSS-Wert von 10,0. Um 21:30 Uhr zog das PHP-Team den Release um einen Tag auf Mittwoch 16 Uhr vor, „the best compromise“, wie die Foundation schreibt. Gegen 22 Uhr veröffentlichte Calif versehentlich ein Video mit einem funktionierenden Proof of Concept gegen mehrere Ziele, das sich in Kopien sofort verbreitete, und um 1 Uhr nachts könnten laut Foundation auch die Mitigationshinweise durchgesickert sein, die vorab an Betreiber kritischer Infrastruktur gegangen waren. Laut BBC hatte das Weiße Haus die US-Bundesbehörden schon am Freitag informiert und mit den KI-Laboren an dem Fix gearbeitet. Am Mittwoch um 5:02 Uhr schaltete Cloudflare seine WAF-Regeln scharf, neun Stunden vor der Veröffentlichung, und berichtet, bereits davor Angriffsverkehr auf Kunden gesehen zu haben. Um 9:34 Uhr meldeten Hosting-Partner bei Patchstack erste Angriffsversuche, um 9:41 Uhr veröffentlichte Chainguard gepatchte Container-Images und brach damit das Embargo, mehr als sechs Stunden vor dem Termin, was die Foundation mit den Worten „unilaterally broke the embargo“ und „disregarded weeks of work by many parties“ kommentiert. Um 15:30 Uhr, eine halbe Stunde früher als angekündigt, lagen die Releases 8.5.12, 8.4.27, 8.3.36 und 8.2.35 vor, um 15:34 Uhr gingen die GitHub-Advisories online. Release-Manager Volker Dusch gegenüber heise: „Nach vielen Wochen Arbeit bin ich sehr froh, dass wir den Release geschafft haben.“
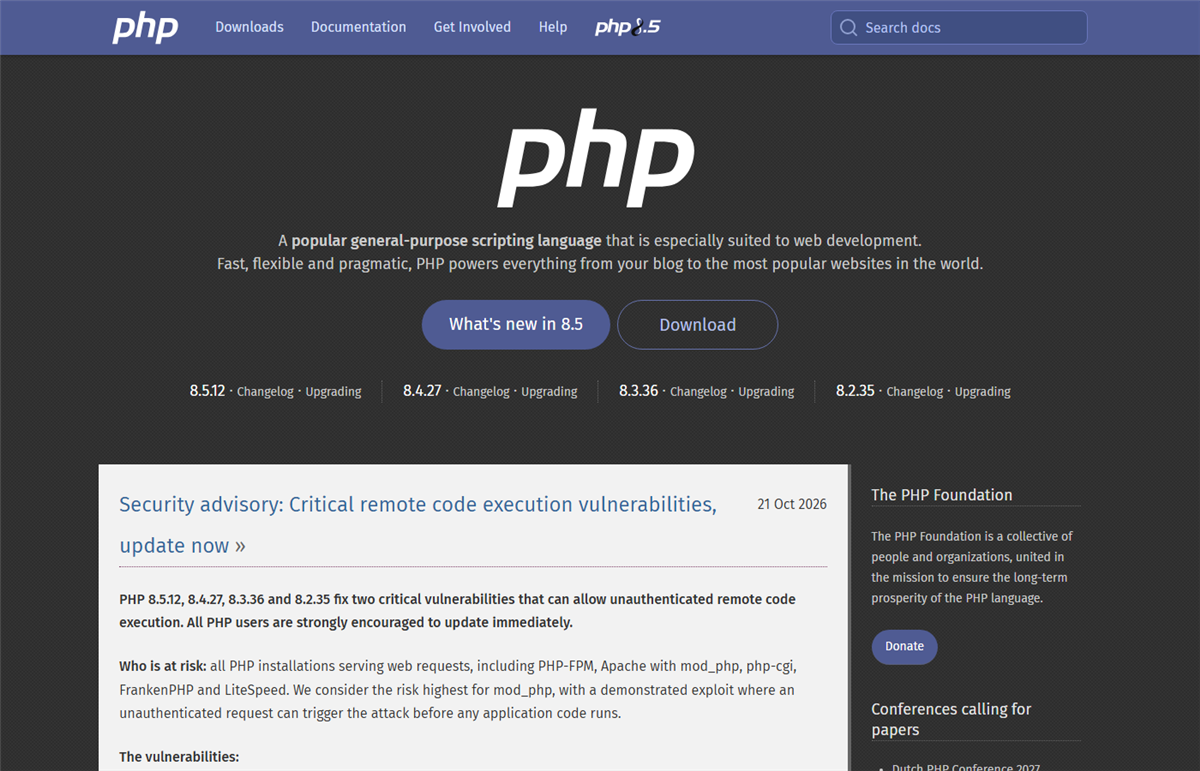
Wichtig für alle, die noch auf älteren Versionen unterwegs sind: Offizielle Releases gibt es nur für die vier unterstützten Zweige 8.2 bis 8.5. Für PHP 7.4, 8.0 und 8.1 hat das Security-Team wegen der Schwere ausnahmsweise minimale Quellcode-Backports in eigenen Branches bereitgestellt, Pakete daraus müssen aber die Distributionen bzw. Hoster bauen. Ondřej Surý, dessen Pakete die meisten Debian- und Ubuntu-Admins kennen, liefert laut Linux Compatible sogar Builds von 5.6 bis 8.5. Und nicht vergessen: PHP 8.2 ist am 31. Dezember 2026 am Ende seines Lebens.
Was die Behörden raten: Patchen oder Stecker ziehen
Das BSI hat am Mittwoch die Warnstufe 3 von 4 ausgerufen, also Orange, und Vizepräsident Thomas Caspers ließ sich mit dem Satz zitieren, man halte „eine kurzfristige, großflächige Ausnutzung innerhalb weniger Stunden“ nach Erscheinen der Patches für wahrscheinlich, weil Angreifer mit KI-gestützten Werkzeugen einen Patch heute binnen kurzer Zeit analysieren und daraus einen Exploit bauen können. Im Sicherheitshinweis steht ein Satz, den man vom BSI selten liest: „Sollten Patches nicht umgehend installiert werden können, empfiehlt das BSI eine vorübergehende Trennung vom Internet zu erwägen, da alle Workarounds keinen vollständigen Schutz vor Angriffe bieten.“ Dasselbe sagen praktisch alle anderen: Die US-Behörde CISA schreibt, wer nicht sofort patchen kann oder noch PHP 8.1 oder älter nutzt, solle PHP-Systeme vom Netz nehmen, die NSA ebenso, das britische NCSC rät, Systeme „offline until it can be fully mitigated“ zu nehmen, CERT-EU empfiehlt die Isolation, CERT-FR will betroffene Geräte isoliert und notfalls Multipart-Uploads blockiert sehen, und CERT.at in Österreich schrieb schon am Montag um 23:20 Uhr: „Wenn möglich, können Sie auch in Erwägung ziehen, Systeme herunterzufahren.“ Das Schweizer BACS bringt es auf den Punkt, warum eine WAF allein nicht reicht und warum nach dem Patch die Arbeit weitergeht: „Ein Update beseitigt keine bereits erfolgte Kompromittierung.“ Der Grund für die ungewohnte Deutlichkeit ist, dass das PHP-Team selbst schreibt, es gebe keine vollständigen Gegenmaßnahmen, nur das Update sei sicher. Bevor Ihr jetzt denkt, dass das Panikmache ist: heise schreibt, dass ein Angriff nicht beim ersten Versuch gelingt, sondern mehrere tausend bis zehntausende Requests braucht, aber Calif hat laut demselben Bericht auf einem Laravel-Server nach 38 Sekunden Systembefehle ausgeführt.
Deutschland: Vom Innenministerium bis zur Internetwache
Entsprechend sah der Mittwoch hierzulande aus. Auf Bundesebene waren zeitweise das Innenministerium, die Bundespolizei, das RKI und der Zoll nicht erreichbar. Bayern schaltete zahlreiche Seiten des Freistaats ab, inklusive Ministerien und Polizei, und die Sprecherin des Landesamts für Sicherheit in der Informationstechnik nannte das „eine reine Vorsichtsmaßnahme“, es gebe „keine Anzeichen für einen Hackerangriff“; am Abend meldete bayern.de über Instagram, die Einschränkungen seien behoben. Baden-Württemberg nahm Landesregierung, Ministerien und Regierungspräsidien für mehrere Stunden vom Netz, Innenminister Hagel: „Wir müssen deshalb jederzeit in der Lage sein, exponierte Systeme bei akuten Gefährdungen kurzfristig vom Netz zu nehmen.“ Hessen und Thüringen setzten ihre Landesportale und Ministerien aus, dazu die Landesämter für Verfassungsschutz in Bayern, Hessen und Thüringen. In Berlin traf es über das ITDZ die Landesseiten, das Abgeordnetenhaus, die Feuerwehr und die Internetwache der Polizei, die ihren Bürgern knapp mitteilte: „Bitte wählen Sie im Notfall die 110.“ Bei den Kommunen nahmen Mainz („betrifft rein den externen Webauftritt“), Dresden („voraussichtlich bis Donnerstag“), Köln, Düsseldorf, Schwerin, München, Augsburg, Potsdam, Halberstadt und der Landkreis Dahme-Spreewald ihre Portale vom Netz, der Deutschlandfunk meldete am Abend schlicht: „Kommunen schalten Internetdienste vorsorglich ab.“ Um 22 Uhr waren Mainz, Dresden, Köln, Düsseldorf und Schwerin noch dunkel.
Update Donnerstag, 22. Oktober, 8:30 Uhr: Köln und Düsseldorf sind wieder erreichbar, ebenso Bundespolizei, Berliner Feuerwehr und die Polizei Berlin. Mainz, Dresden und Schwerin sind weiterhin offline, der Landkreis Dahme-Spreewald meldet noch „Zugriff eingeschränkt“, und bei der Stadt München stehen die Onlinedienste laut Rathausseite nach wie vor nicht zur Verfügung.
Bei den Kliniken machte die Charité den Anfang, schaltete Website und Online-Terminbuchung ab und betonte über ihren Sprecher Markus Heggen, das habe „keinerlei Einfluss auf die Arbeit der Charité“, die Updates sollten bis Donnerstag eingespielt sein; am Abend war die zentrale Seite wieder da. Es folgten Vivantes („Die medizinische Versorgung in all unseren Häusern ist vollständig sichergestellt“), die MHH Hannover, das Harzklinikum in Sachsen-Anhalt, die Unikliniken Freiburg, Heidelberg und Mannheim, das Uniklinikum Augsburg, das Klinikum Nürnberg und das Ernst-von-Bergmann-Klinikum in Potsdam. Die Universitäten gingen besonders rigoros vor: Die Uni Hamburg schaltete „alle Online-Dienste der Universität, die auf dieser Basis funktionieren“ ab, die RWTH Aachen machte ihre Dienste nur noch per VPN erreichbar, die Uni Mannheim nahm Website, Intranet, bwSync&Share und Onlinebewerbung vom Netz, die TU Dresden listete in ihrem Betriebsstatus von Datashare über eduVPN bis Matomo zwei Dutzend Dienste als „bis auf Weiteres nicht zur Verfügung“, Münster trennte ILIAS und sciebo, Göttingen Website, StudIP und Newsletter mit der ehrlichen Begründung: „Es ist gut möglich, dass in den kommenden Tagen diese Situation ausgenutzt wird.“ Dazu kamen die Uni Freiburg, Potsdam, Kiel, Konstanz, Regensburg („Es handelt sich um eine reine Vorsichtsmaßnahme, es gibt keinerlei Hinweise auf einen Angriff!“), die Ruhr-Universität Bochum, die HU und FU Berlin und das WZB.
Update Donnerstag, 22. Oktober, 8:30 Uhr: Charité, Vivantes, die Uni Regensburg und die Uni Potsdam sind zurück. Die MHH Hannover zeigt noch „Service Unavailable“, die Universitäten Mannheim, Göttingen, Kiel, Konstanz und Bochum stehen weiter auf ihren Notfall- bzw. Wartungsseiten, und die Uni Hamburg weist auf der Startseite nach wie vor auf die abgeschalteten Dienste hin.
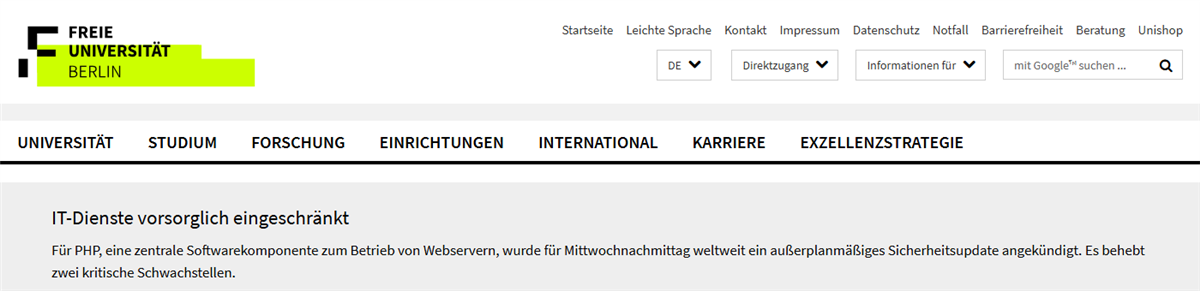
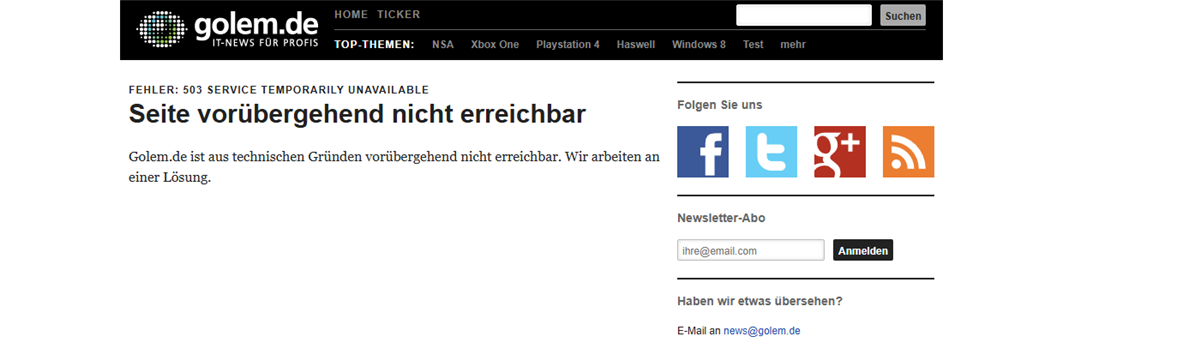
Auch Medien und Firmen traf es. golem.de zeigte den ganzen Nachmittag und Abend eine 503-Seite, zeit.de war zeitweise schwarz, die Rechnungssoftware easybill, Checkmk und die SPD-Bundestagsfraktion gingen in die Wartung. ComputerBase dagegen hatte, wie die Kollegen selbst schreiben, „schon in der Nacht Vorkehrungen getroffen“ und lief um 16:50 Uhr bereits auf PHP 8.5.12, eine knappe Stunde nach dem Release, ließ aber die Sperre für VPN-Zugriffe noch stehen.
Update Donnerstag, 22. Oktober, 8:30 Uhr: golem.de und easybill sind seit der Nacht wieder online, die SPD-Bundestagsfraktion steht noch auf der Wartungsseite.
Österreich und Schweiz: Unis, Voestalpine, Wiener Linien
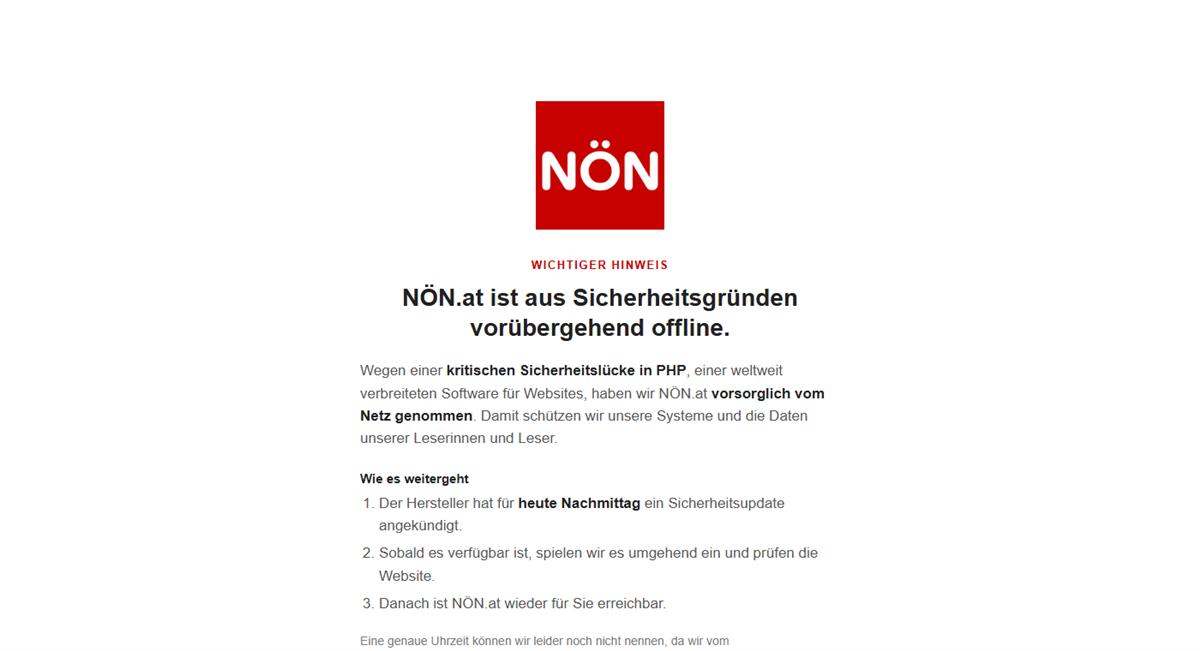
In Österreich verbreitete das Innenministerium die CERT.at-Warnung „in Abstimmung mit dem neuen Bundesamt für Cybersicherheit“, und die Unis reagierten wie in Deutschland: Uni Wien (Moodle, u:cloud, Webmail), WU, BOKU, MedUni Wien, JKU Linz und die Uni Innsbruck samt Innsbrucker Kommunalbetrieben nahmen Dienste vom Netz. Dazu kamen Voestalpine, deren Website noch am späten Abend meldete, dass aktualisierte und geprüfte Systeme „progressively“ zurückkämen, Novomatic, Cineplexx, die Arbeiterkammer, das Landesportal Burgenland, der ÖAMTC, die Stadt Wels, das Klinikum Wels-Grieskirchen, die Caritas, die NÖN und die Echtzeitdaten der Wiener Linien, deren App ausfiel, „die Öffis fahren aber alle normal“. In der Schweiz schaltete die Universität Genf ab, die EPFL suspendierte den Zugriff auf alle ihre Webseiten „pour procéder aux vérifications de sécurité nécessaires“, die Buchhaltungssoftware bexio pausierte komplett, watson riegelte sich weitgehend ab und der Hoster cyon nahm sämtliche Kundenseiten offline. SRF-Redakteur Jürg Tschirren fasste den Stand am frühen Abend zusammen: „Bestätigte Einbrüche gibt es bisher nicht.“
Update Donnerstag, 22. Oktober, 8:30 Uhr: NÖN, Voestalpine, die Stadt Wels, die JKU Linz, bexio, die EPFL und watson sind wieder da. Die MedUni Wien, das Landesportal Burgenland und die Universität Genf sind weiterhin offline.
Europa: Den Haag, Helsinki, Kopenhagen, Swindon
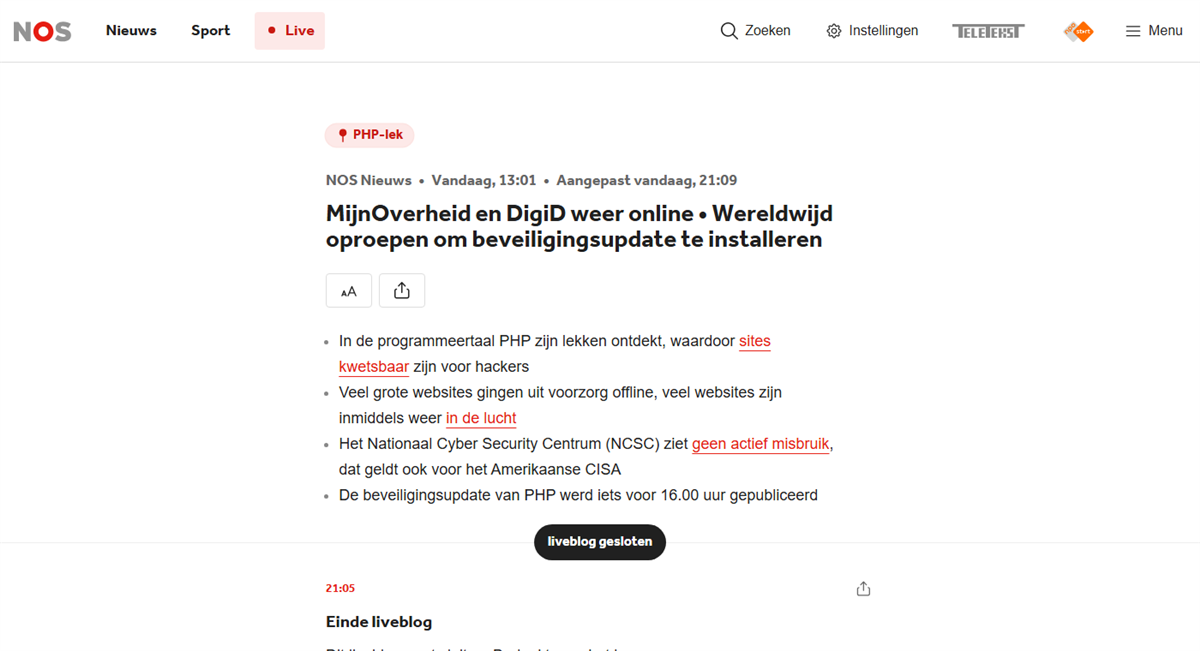
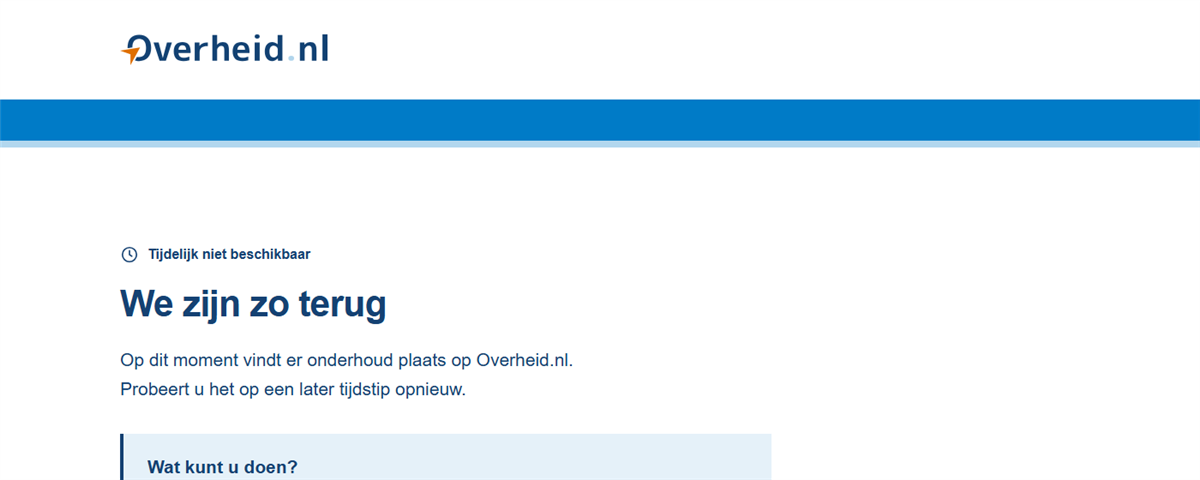
Noch drastischer war es in den Niederlanden, wo NOS den ganzen Tag einen Liveblog führte. Um 12:48 Uhr gingen DigiD und MijnOverheid offline, kurz darauf die Tweede Kamer, das NCSC-NL und die Datenschutzbehörde selbst, die Portale von NotuBiz, über die mehr als hundert Gemeinden ihre Ratsinformationen veröffentlichen, der Sender RTL samt App, Tweakers, der Fußballverband KNVB mit mehreren Erstligavereinen, die Schiphol-App, ein halbes Dutzend Krankenhäuser, die Hilfsorganisationen von Amnesty bis Oxfam und mehrere Parteien. Die Vizedirektorin des NCSC-NL, Corine Schipper-Derkse, brachte es im Liveblog auf den Punkt: Es handle sich „nicht so sehr um einen Angriff, sondern um einen Webfehler“, und man solle den Patch einspielen, damit das Loch gestopft sei. Am Abend kamen die meisten zurück, MijnOverheid um 18:11 Uhr, DigiD um 20:27 Uhr, die Tweede Kamer gegen 21:30 Uhr, overheid.nl war beim Schreiben dieser Zeilen noch dunkel.
In Belgien schaltete Flandern sämtliche Regierungsseiten und das Parlament ab, dazu das Außenministerium, die Schulplattform Smartschool, die Magazine von Roularta, Teile von DPG Media und das Antwerpener Spital AZ Monica, sogar die Website des Cyber-Zentrums CCB war weg. Finnlands staatlicher IT-Dienstleister Valtori nahm die öffentlichen Webdienste der Regierung komplett vom Netz, vom Katasteramt über Oikeus.fi und das Meteorologische Institut bis zum Reichsarchiv, und begründete das damit, dass man nur eine Teilliste der betroffenen Dienste habe und deshalb lieber breit abschalte; auch Teile von Yle waren weg. In Dänemark schloss Kombit die Schulplattform Aula, der Wetterdienst DMI schaltete seine digitalen Dienste ab, Bibliothekssysteme und die Auszahlung von Sozialleistungen waren teilweise betroffen. Frankreich nahm die Seiten der Präfekturen in Wartung, in Großbritannien gingen die Councils von Swindon („a precaution because of a worldwide issue with the underlying technology and is not a cyber incident“) und Edinburgh offline und selbst einzelne Programmseiten der BBC waren nicht erreichbar. Die CERTs von Schweden, Italien, Spanien und Polen gaben gleichlautende Warnungen heraus, und ENISA listet in einer gemeinsamen Meldung die Hinweise aller 27 nationalen CSIRTs.
Update Donnerstag, 22. Oktober, 8:30 Uhr: NOS hat den Liveblog am Mittwoch um 21:05 Uhr geschlossen. Inzwischen sind overheid.nl, die Tweede Kamer, DigiD, MijnOverheid, das NCSC-NL, der KNVB, die flämische Regierung, Smartschool, Aula, der dänische Wetterdienst und der Swindon Borough Council wieder online. Das finnische Katasteramt Maanmittauslaitos zeigt noch eine Wartungsseite.
Und der Rest der Welt: Kanada, Tokio, Wikipedia
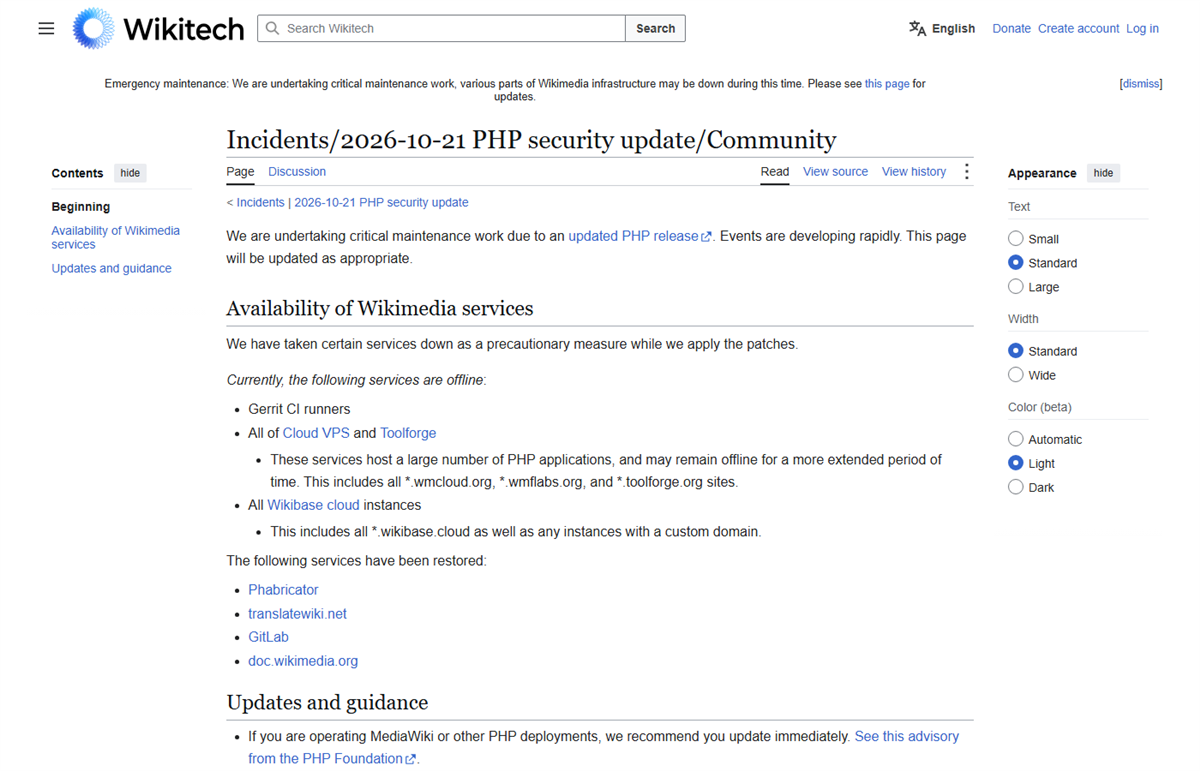
In den USA blieben die Bundesseiten laut Newsweek online, dafür gingen Pinboard, Something Awful, DeviantArt und 4chan in die Wartung, 4chan ist seitdem nur noch lesbar, „while we await an urgent PHP security update“. Die Wikimedia Foundation hat Toolforge, Cloud VPS, Wikibase Cloud und zeitweise Phabricator abgeschaltet und bestätigte ab 17 Uhr auch Ausfälle der Wikis selbst, weil ehrenamtlich betriebene Dienste erst zurückkommen können, wenn ihre Betreiber die PHP-Version angefasst haben. Kanadas Minister Evan Solomon bestätigte, dass einige Bundeswebseiten „as a precaution to protect government systems and Canadians‘ information“ offline seien, das Wirtschaftsministerium ISED darunter, und Rajiv Gupta vom kanadischen Cyber Centre nannte PHP schlicht „ubiquitous“. In Australien meldete ausgerechnet cyber.gov.au, die Seite der Cyber-Sicherheitsbehörde, Ausfälle. Und in Japan forderte Premierministerin Sanae Takaichi die Behörden auf zu prüfen, ob ihre Seiten PHP nutzen, während die Spieleindustrie reihenweise in die Notfallwartung ging: Square Enix sperrte neue Logins zu Final Fantasy XIV auf allen Welten und nahm die Patch-Server offline, Cygames schickte Umamusume, Granblue Fantasy, Shadowverse und Princess Connect in die Wartung, Pokémon Sleep, Pokémon HOME und Pokémon Champions folgten, ebenso Sega mit CHUNITHM, Bandai Namco ID und Niconico. Dazu der Hoster Sakura Internet, die Shop-Plattformen BASE und Color Me Shop und die Kita-Software Kodomon.
Update Donnerstag, 22. Oktober, 8:30 Uhr: Something Awful, Pinboard und DeviantArt sind zurück, 4chan hängt hinter einer Verifikationsseite, deren Status sich nicht beurteilen lässt. Das kanadische Wirtschaftsministerium ISED meldet weiterhin „Service Unavailable“. Bei Wikimedia sind Phabricator, translatewiki und doc.wikimedia.org wieder da, Cloud VPS, Toolforge und sämtliche Wikibase-Cloud-Instanzen bleiben laut Wikitech (Stand 3:32 Uhr) offline, weil dort jeder Betreiber seine eigene PHP-Version anfassen muss.
Hoster: Wer hat gepatcht, wer ist noch dunkel?
Für die meisten von Euch ist das die eigentlich wichtige Frage, denn wer ein Webhosting-Paket hat, kann selbst gar nichts patchen, sondern muss darauf warten, dass der Hoster es tut. Hier der Stand von Mittwoch gegen 22 Uhr, zusammengetragen aus den Statusseiten und aus den Leserkommentaren bei Günter Born und Caschy, die ich entsprechend kennzeichne, weil sie nicht von den Anbietern selbst stammen:
| Hoster | Stand Mittwoch, 22 Uhr |
|---|---|
| Mittwald | Sämtliche Kundenwebseiten seit dem Nachmittag offline, nur E-Mail läuft; 21:28 Uhr: Patches werden eingespielt, „bis Mitternacht“ sollen die meisten Systeme zurück sein, erste Prüfungen ohne Hinweise auf Ausnutzung; für PHP 5.6, 7.0, 7.1 und 8.0 noch keine Lösung |
| netcup | Webhosting und Managed Server ab 16:25 Uhr vom Netz („Um Sie und Ihre Daten zu schützen, haben wir alle potenziell gefährdeten Systeme vorsorglich vom Internet getrennt“); 21:02 Uhr: Managed Server komplett, Webhosting zu 60 Prozent gepatcht und wieder online; Root-Server und VPS müssen selbst patchen |
| Hetzner | Patches für PHP 7.4 und 8.0 bis 8.5 auf allen Webhosting- und Managed-Servern eingespielt, ältere Versionen in Arbeit |
| IONOS | Nextcloud-Instanzen seit 14:26 Uhr vorsorglich deaktiviert; Rollout des PHP-Updates seit 17:44 Uhr mit kurzen Ausfällen, Abschluss „innerhalb der nächsten 24 Stunden“; ein Leser meldete seine Seite um 18:33 Uhr mit 8.3.36 zurück |
| Profihost | Vorbildlich transparent: 10:36 Uhr Info, 12:30 Uhr Workarounds, 20:20 Uhr „8.2, 8.3, 8.4 und 8.5 wurden auf der gesamten Profihost-Infrastruktur aktualisiert“, 5.6 bis 8.1 noch nicht |
| manitu | 8:50 Uhr Wartung angekündigt, 12:10 Uhr Formular-Uploads gesperrt, 20:05 Uhr alle relevanten Systeme aktualisiert, Upload-Sperre bleibt vorerst |
| Timme Hosting | 15:31 Uhr wegen gemeldeter aktiver Ausnutzung alle Websites und ISPConfig-Oberflächen deaktiviert, 19:24 Uhr PHP 8.2 bis 8.5 gepatcht und wieder frei, ältere Versionen bleiben auf einer Wartungsseite |
| Strato | Kein offizieller Hinweis gefunden; laut Leserkommentar um 19:10 Uhr gepatcht |
| all-inkl | Kundenportal und Homepage am Abend nicht erreichbar, KAS-Login ging; laut Kommentar liefen Webspaces um 19:27 Uhr noch auf PHP 8.4.24 |
| DomainFactory | 18:46 Uhr Neustart der Anwendungsdienste, 20:48 Uhr: „Wir sind uns der PHP-Sicherheitslücken bewusst, haben Schutzmaßnahmen getroffen“; laut Kommentar um 20:09 Uhr noch ungepatcht |
| checkdomain, Alfahosting, dogado | Gleichlautende Statusmeldungen der dogado-Gruppe ab 15:34 Uhr: Installation „mit höchster Priorität“ |
| webhostone, webgo | webhostone meldet die Patches auf allen Shared- und Managed-Systemen als bereitgestellt, webgo spielt sie laut Banner gerade ein |
| Uberspace | PHP um 15:45 Uhr laut heise komplett abgeschaltet, bis die Patches da sind |
| Host Europe | Statusseite: „Wartung des Hostings“ seit 18:46 Uhr, Dienste werden neu gestartet |
| easyname (AT) | Ab 9:34 Uhr Status, 16:27 Uhr Installation „mit höchster Priorität“, Webspace-Kunden müssen nichts tun |
| cyon, Metanet, Hostpoint, Infomaniak (CH) | cyon alle Websites offline bis voraussichtlich 22 Uhr; Metanet patcht Shared und Managed selbst; Hostpoint ohne Meldung; Infomaniak mit Schutzmaßnahmen im Hosting bis Donnerstag 3 Uhr und eingeschränktem Dateiversand bei SwissTransfer |
| Kinsta, Cloudways, SiteGround, Laravel Cloud, Craft Cloud | Kinsta hatte die eigenen Seiten um 16:38 Uhr auf 8.5.12, PHP-8.3-Kunden warteten noch; Cloudways und SiteGround mit Übergangsschutz; Laravel Cloud und Craft Cloud patchten automatisch, Laravel Forge-Kunden müssen selbst ran |
| Plesk, cPanel/CloudLinux, DirectAdmin, ISPConfig | Plesk liefert Updates für seine PHP-Versionen, CloudLinux patcht alt-php 7.4/8.0, DirectAdmin bietet 8.2.35 bis 8.5.12 plus eigene 7.4/8.0/8.1-Backports, ISPConfig verweist auf das PHP-Update und bietet eine temporäre Multipart-Sperre |
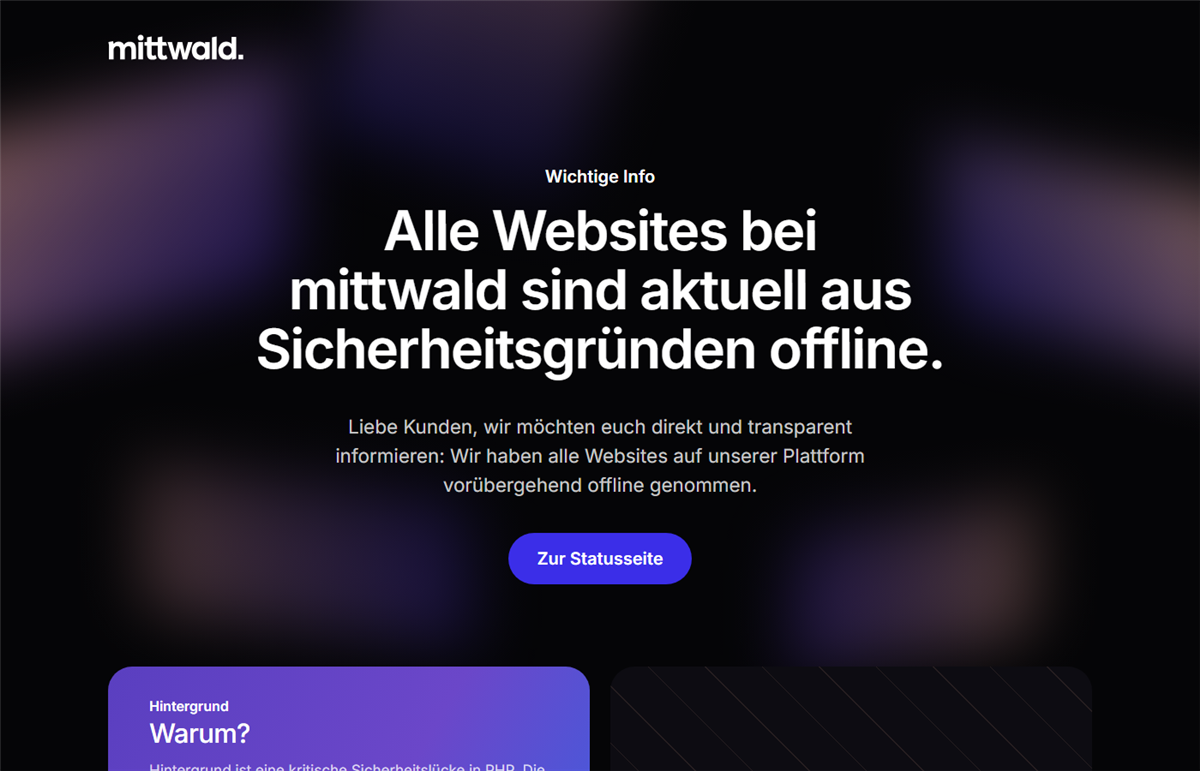
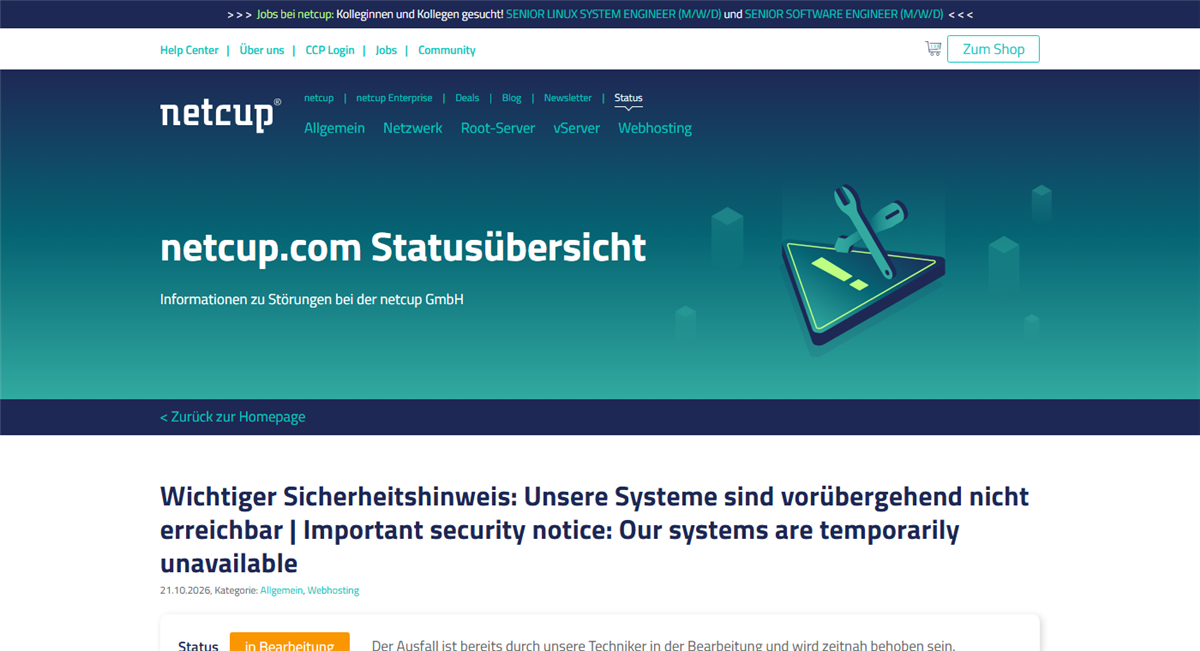
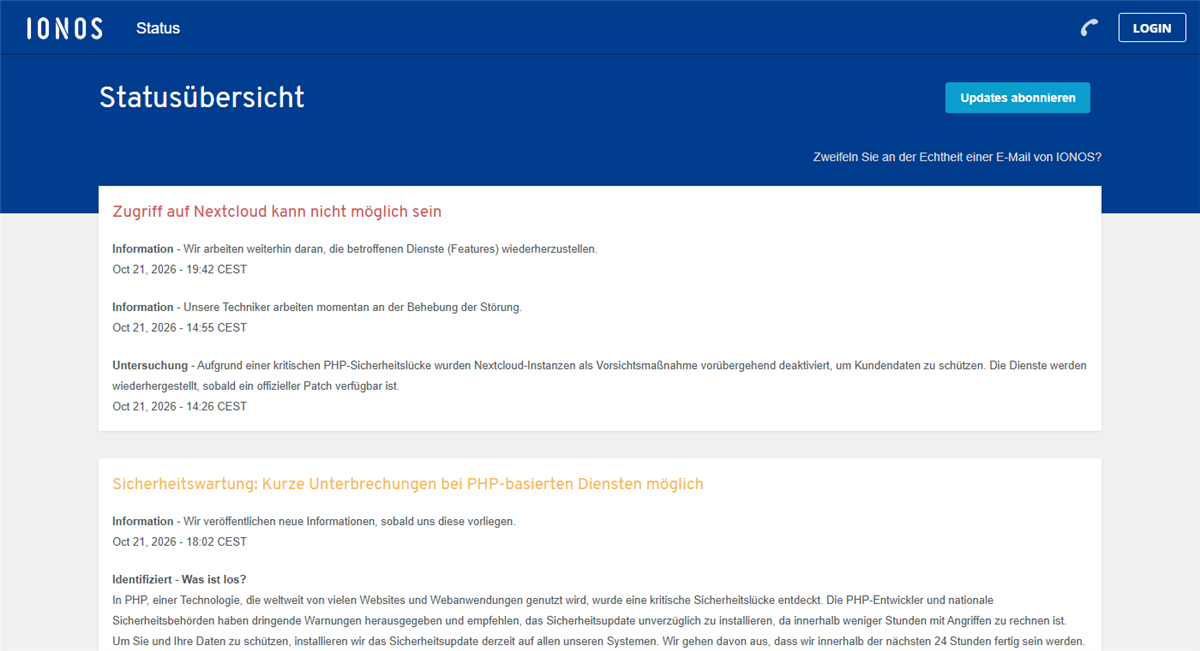
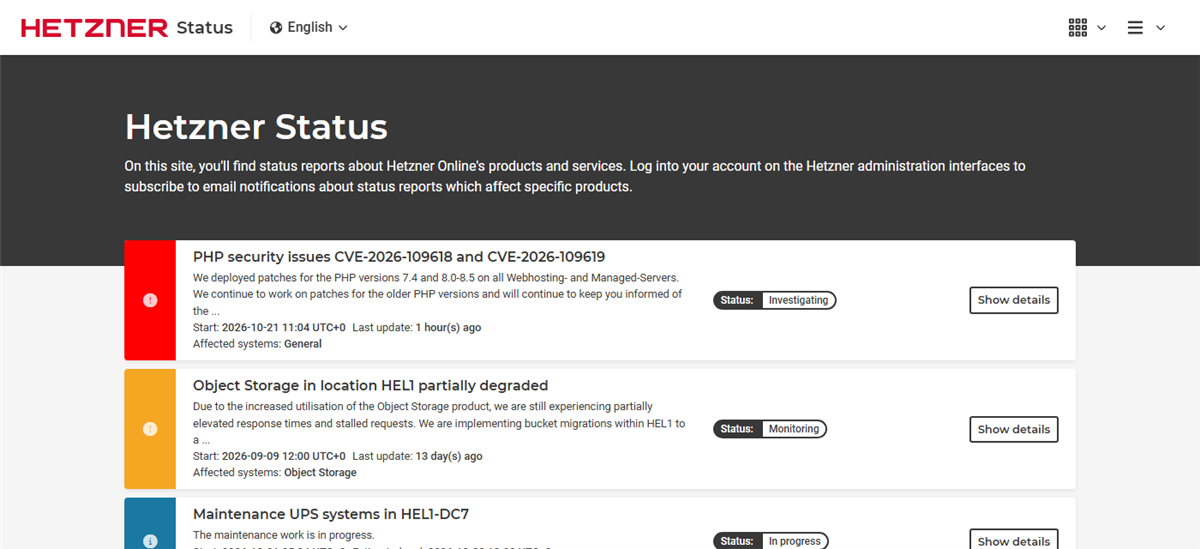
Drei Dinge fallen auf. Erstens hängt die Geschwindigkeit nicht an der Größe des Hosters, Hetzner und Profihost waren durch, während Mittwald noch komplett dunkel war. Zweitens zeigen die Kommentare bei BornCity und Caschy, dass einige Hoster um 19 oder 20 Uhr noch alte Versionen auslieferten, obwohl die Patches seit 15:30 Uhr vorlagen, und das bei einer Lücke, bei der das BSI mit Ausnutzung „innerhalb weniger Stunden“ rechnet. Drittens hat sich die Abschaltung als die ehrlichere Variante herausgestellt: Wer wie netcup, Mittwald, Timme oder cyon alles vom Netz nahm, hat seinen Kunden ein paar Stunden Ausfall zugemutet, aber kein Zeitfenster für Angreifer gelassen. Wer wissen will, ob der eigene Hoster schon durch ist, sollte übrigens nicht auf die PHP-Versionsnummer im Kundenmenü vertrauen, denn Distributionen und Hoster portieren Fixes oft in bestehende Paketversionen zurück, ohne die Nummer zu ändern.
Update Donnerstag, 22. Oktober, 8:30 Uhr: netcup meldete um 23:45 Uhr alle Webhosting-Pakete als gepatcht und online, das Webhosting-Control-Panel folgte um 4:09 Uhr nach einem Plesk-Update, Status „behoben“. Mittwald setzte die Störung um 0:28 Uhr auf „gelöst“, nahezu alle PHP-Versionen sind abgesichert, nur für Versionen unterhalb 5.6 wird noch nach einer Lösung gesucht. Hetzner hat inzwischen auch PHP 5.6 und 7.3 auf allen Webhosting- und Managed-Servern gepatcht, Timme Hosting seit 22:20 Uhr alle Versionen von 5.6 bis 8.5. IONOS hat die Nextcloud-Instanzen um 22:55 Uhr wieder freigegeben, die Sicherheitswartung für Webhosting, WordPress-Hosting und MyWebsite lief um 6:53 Uhr noch. DomainFactory hat seit 20:48 Uhr kein Update veröffentlicht, Shared und Web Hosting stehen weiter „Under Maintenance“ und die Homepage war morgens nicht erreichbar. Bei Profihost sind PHP 5.6 bis 8.1 weiterhin nicht gepatcht, manitu lässt die Upload-Sperre vorerst stehen, Host Europe führt die Hosting-Wartung noch als offen, Infomaniak hält den Dateiversand bei SwissTransfer und kSuite weiter eingeschränkt (Update 8:11 Uhr). Die Homepages von all-inkl, Uberspace, Hostpoint und Mittwald laufen wieder normal.
Und die Blogosphäre?
Weil ich selbst Blogger bin, habe ich am Abend rund 80 deutsche und englische Blogs abgeklappert, um zu sehen, wie es dort aussieht. Die Kurzfassung: Die Blogosphäre lebt, aber einige haben sich bewusst selbst den Stecker gezogen. ifun.de und iphone-ticker.de gingen um 16 Uhr auf Beschluss ihres Hosters offline, mit der schönen Begründung, man ziehe „kurz den Stecker, bevor es jemand anderes für uns tut“, und die 16 Kommentare darunter bestehen vor allem aus Daumendrücken. LinuxNews.de kündigte um 11:24 Uhr eine Wartung ab 15:50 Uhr an und war 25 Minuten später gepatcht wieder da („Patching braucht eben seinen Moment“). Besonders lesenswert ist der Bericht von kernel-error.de, der seinen Blog auf FreeBSD-Jails betreibt: Er hat nginx gestoppt, bevor es überhaupt einen Patch gab, dann festgestellt, dass das Binärpaket noch auf 8.3.35 stand, während der Ports-Tree den Fix binnen Minuten hatte, hat PHP samt 43 Erweiterungen selbst gebaut, ist über ein fehlendes CA-Bundle gestolpert und hat anschließend 15 Tage Logs durchsucht. Seine Lehre: Eine neue Versionsnummer beweist nicht den richtigen Fix, ein neues Binary nicht, dass der Dienst es nutzt, und ein grüner Konfigurationstest nicht, dass die Seite funktioniert. Caschy, Günter Born (mit über 80 Kommentaren der beste Lagebericht zu deutschen Hostern), Deskmodder, Dr. Web, Sir Apfelot, t3n, netzwelt, Apfeltalk und Notebookcheck berichteten alle am selben Nachmittag, WinFuture titelte treffend „Kein Feierabend für Admins“. Sir Apfelot, selbst All-Inkl-Kunde, liefert nebenbei den wichtigen Hinweis, dass Wartungsmodus-Plugins und die .maintenance-Datei von WordPress hier nichts bringen, weil PHP den Request dann längst verarbeitet hat, die Sperre muss per .htaccess oder am Webserver passieren. Auffällig still blieben dagegen ausgerechnet die WordPress-Fachblogs: WP Tavern hatte bis zum Abend keinen einzigen Beitrag, der Wordfence-Blog auch nicht, und bei perun.net, Pressengers, WP Ninjas und Elmastudio stand nichts auf der Startseite. golem.de war um 22 Uhr immer noch dunkel, mit einer Störungsseite, auf der laut einem Mastodon-Nutzer noch das Copyright 2014 und ein Google+-Link stehen, und auch mwop.net, der Blog von Laminas-Maintainer Matthew Weier O’Phinney, zeigte „Site Maintenance“. Wer auf WordPress.com oder Tumblr bloggt, war laut Automattic durchgehend geschützt, und wer auf Blogger, Ghost, Substack oder Medium schreibt, hat mit PHP ohnehin nichts zu tun.
Update Donnerstag, 22. Oktober, 8:30 Uhr: ifun.de, iphone-ticker.de, LinuxNews.de, kernel-error.de, golem.de und mwop.net sind alle wieder online.
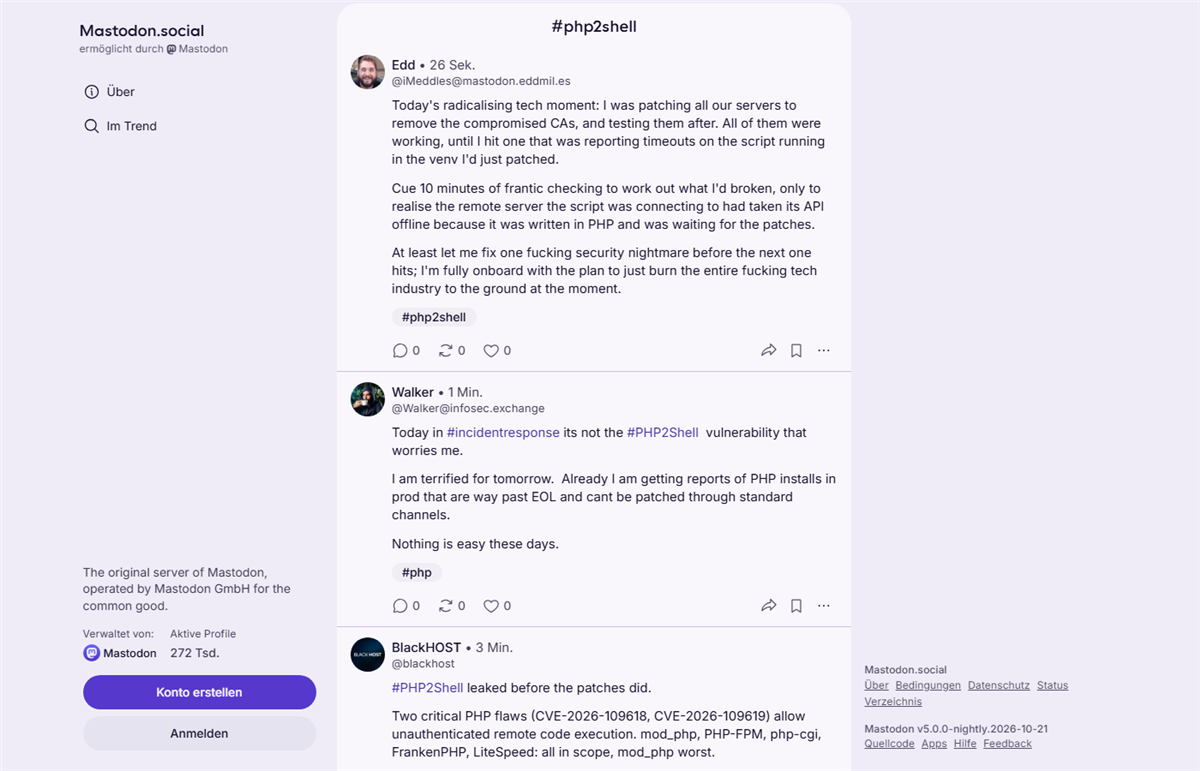
Richtig laut war es auf Mastodon. Allein auf mastodon.social liefen zwischen 18 und 22 Uhr 200 Beiträge mit dem Hashtag #php2shell auf, also rund 50 pro Stunde, auf mastodon.online und tchncs.de kamen in der letzten Stunde je 40 dazu. Torsten Landsiedel aus der deutschen WordPress-Community fasste seinen Tag unter #PHPocalypse zusammen: „Meinen Urlaub an der Nordsee habe ich mir auch anders vorgestellt … all-inkl.com komplett down, DomainFactory erreichbar, aber noch kein Update in Sicht. Wie sind eure Erfahrungen mit euren Hostern?“ Die Antworten darunter sind eine kleine Hoster-Rangliste aus Entwicklersicht: Uberspace die schnellste Reaktion, wenn auch mit Zwangs-Upgrade von 8.1 auf 8.2, netcup und Hetzner langsamer, aber mit Information, all-inkl mit Instagram als einzigem Infokanal, webgo und checkdomain um 21:40 Uhr noch auf 8.4.26, ein kleiner Hoster um 17:30 Uhr gepatcht und online („Zusendung eines Geschenkekorbs angesagt“), und ein Entwickler, der seine eigenen Server „innerhalb von Minuten“ versorgt hatte, bei den Hostern aber „bisher nichts zu sehen“ fand. „Netcup sind auch gefühlt die einzigen, die es hinbekommen, die Kundschaft auf dem Laufenden zu halten“, schrieb ein anderer und bekam dafür die meisten Favoriten des Abends. Bei Strato und IONOS meldete ein Nutzer um 17:22 Uhr noch alte Versionen und um 20:07 Uhr Vollzug, bei all-inkl kam um 21:03 Uhr ein knappes „ist fertig. Danke!“. Weniger begeistert waren die Nextcloud-Kunden von Hetzner („meine Nextcloud ist jetzt seit 6h offline“, „What do I look like, an Office 365 customer?“), ein Admin wartete dreieinhalb Stunden darauf, dass Hetzners Ubuntu-Spiegel die Sicherheitsupdates überhaupt synchronisierte, und Docker-Nutzer zählten die „langen Minuten“, bis die offiziellen Images endlich kamen, um 20:07 Uhr jubelte einer: „The official WordPress image on Docker Hub JUST updated to PHP 8.3.36!“ Dazwischen Galgenhumor („Ich bin so froh, dass meine Webseiten immer noch mit dem Flash Player laufen“), Erleichterung („heute sind wir echt froh, dass wir unseren alten WordPress-Stack abgeschaltet haben“) und Betreiber, die ihre Seiten schlicht zusperrten: „Alle meine Blogs und Webseiten erst mal zugesperrt. Von meinen Home-Office-Containern ist anscheinend nur BookStack betroffen.“
Auf Hacker News sammelte der Wiz-Beitrag bis zum Abend über 400 Punkte und 160 Kommentare, und die Stimmung dort ist deutlich skeptischer als in den Pressemitteilungen. Die meistdiskutierte Frage war, warum zwischen Meldung und Fix zwei Monate lagen, die zweithäufigste, ob „KI hat es gefunden“ nicht vor allem Marketing sei, ein Kommentator spottete, der Fund werde vermarktet, „as if it were the first RCE found in human history“, ein anderer kommentierte die 70-Prozent-Zahl mit „that’s my depressing statistic for the day“. Im Thread zu den verspäteten Docker-Images reichte das Spektrum von „Never using docker hub ever again“ bis zu der nüchternen Feststellung, dass die meisten PHP-Nutzer ihr PHP ohnehin als Distributionspaket bekommen und genau dieser Weg die Arbeit gebraucht und bekommen habe. Lesenswert aus der PHP-Welt selbst: Alexandre Daubois vom Security-Team der PHP Foundation hat in seinem Blog aufgeschrieben, was an den Gerüchten falsch war, der CVSS-Wert war nie 10,0, watchTowr listete ein PHP 6, das es nie gab, der meistgeteilte Workaround galt für die falsche CVE und der im Advisory an erster Stelle genannte, memory_limit=-1, tauchte in keinem der Artikel auf. Nick Rogers vertritt auf Substack die These, dass PHP2Shell längst „in den Trainingsdaten“ lag, weil Stefan Esser den Mechanismus schon 2004 beschrieb, ein Bugreport von 2019 ihn streifte und das Audit 2024 ihn fand, und dass KI nicht die Lücke entdeckt, sondern die Kosten gesenkt habe, aus einem bekannten Speicherfehler einen Exploit zu bauen. OpenAI hat derweil einen kleinen Versionsprüfer namens php2shell-checker auf GitHub gestellt, der aber nur Header und php -v auswertet und selbst warnt, dass „UNKNOWN“ nicht „gepatcht“ heißt, Wiz betreibt die Infoseite php2shell.com, Josh Bowen beschreibt, wie er seine alten PHP-7.4-Container mit dem Backport-Branch selbst gepatcht hat, und Steve Grunwell, der bei Mailchimp eine 20 Jahre alte PHP-Anwendung auf PHP 8 gehoben hat, bringt es auf den Satz, der heute für alle gilt: „Running a PHP application means regular upgrades.“
Plattformen, Container und Appliances: Wer sonst noch betroffen ist
Automattic erklärte am Nachmittag, WordPress.com, WordPress VIP, WP Cloud, Pressable und Tumblr seien „already protected“, Kunden müssten nichts tun. WordPress.org selbst stellte über John Blackbourn klar, dass die Lücken „not specific to WordPress“ seien, dass kein WordPress-Update nötig oder geplant sei und dass Betreiber eigener Server mit PHP vor 8.2 erwägen sollten, ihre Seite offline zu nehmen. Drupal veröffentlichte eine PSA mit demselben Tenor, Matomo erklärte die Cloud für geschützt und wies On-Premise-Nutzer darauf hin, dass ein Matomo-Update die Lücken nicht behebt, Laravel patchte seine Cloud automatisch, verlangte bei Vapor ein Redeploy und bei Forge Handarbeit. Nextcloud hat keinen Blogbeitrag, aber ein angepinntes GitHub-Issue und ein neues All-in-One-Image 14.4.1 mit gepatchtem PHP. Von TYPO3, Joomla, Shopware und Magento habe ich bis zum Abend keine eigenen Statements gefunden.
Bei den Distributionen lieferten Debian (8.4.27 für Trixie, 8.2.35 für Bookworm) und Ubuntu (alle unterstützten Releases bis zurück zu 14.04 über ESM) am Nachmittag, AlmaLinux hatte um 17:11 Uhr Testpakete, Red Hat bis 19:50 Uhr nur das Paket für PHP 7.4 auf RHEL 8, und das Remi-Repository, das viele auf CentOS-Nachfolgern nutzen, bekam am Mittwoch gar kein Update, worauf php.net eigens hinwies. Die offiziellen Docker-Images erschienen erst am Abend, nachdem der zugehörige Pull Request wegen einer hitzigen Diskussion gesperrt worden war. Richtig unangenehm wird es bei Geräten mit PHP-Oberfläche: Palo Alto Networks bestätigt, dass PAN-OS 10.2 bis 12.2 und Panorama verwundbar sind, ein Fix hat „ETA: TBD“, bis dahin soll das Management-Interface abgeschottet werden. Sophos erklärt seine Produkte für nicht betroffen, hat aber das alte MyUTM-Portal vom Netz genommen, weil es eine verwundbare PHP-Version nutzte. Für Synology, QNAP, pfSense, OPNsense, FortiADC, F5 BIG-IP, Citrix NetScaler und Juniper J-Web steht in der Produktliste des niederländischen NCSC überall „Investigation“, und heise nennt zusätzlich Router von DrayTek, ZyXEL, D-Link, TP-Link, Netgear und Tenda. Wer so ein Gerät mit Web-Oberfläche im Internet hängen hat, sollte die Oberfläche jetzt abschotten und auf Firmware warten.
Wird die Lücke schon ausgenutzt?
Ja und nein, je nachdem, wen man fragt, und ich habe mir die Mühe gemacht, die Aussagen nebeneinanderzulegen. Cloudflare berichtet von Angriffsverkehr schon vor der Veröffentlichung und davon, dass die Angreifer ihre Payloads laufend verändern, um die WAF-Regeln zu umgehen. Patchstack meldete um 9:34 Uhr, Hosting-Partner hätten mehrere aktive Angriffe gemeldet, relativierte um 15:57 Uhr aber auf „only probing attacks, with no hard evidence of breaches yet“. Hadrian sprach von Ausnutzung „at scale“, die meisten Versuche über den Upload-Progress-Pfad, watchTowr sah die ersten Versuche in seinem Honeypot-Netz praktisch zeitgleich mit den Patches und schreibt, dass bisher niemand erfolgreich war, man aber nicht erwarte, dass das lange so bleibe. Das NCSC-NL berichtet von massiven automatisierten Scans durch Botnetze innerhalb weniger Stunden nach dem Leak. Auf der anderen Seite stehen Huntress, Imperva, Check Point und Cisco Talos, die bis in den Nachmittag nichts gesehen hatten, die CISA, die zum Zeitpunkt ihrer Meldung keine Ausnutzung beobachtet hatte und die CVEs nicht in ihren Katalog ausgenutzter Lücken aufnahm, das BSI, das von unbestätigten Berichten spricht, und Mittwald, das nach ersten Prüfungen keine Hinweise auf Ausnutzung bei sich fand. Von gefundenen Webshells hat bis zum Abend niemand berichtet, und keine einzige der Quellen nennt harte Zahlen zu Requests oder IPs. Kurzum: Es wird massiv gescannt und probiert, es ist noch nicht belegt, dass es jemand geschafft hat, und genau dieses Zeitfenster ist das, in dem man patchen sollte.
Und bei mir? Docker-Images, Logs und ein Fenster von fünf Stunden
Meine Seiten laufen als Docker-Container mit dem offiziellen Image wordpress:php8.3-apache auf einem VPS bei netcup, und bei einem VPS gilt, was netcup auf seiner Statusseite auch klar sagt: Das Update ist meine Sache. Das Problem bei Docker ist, dass man nicht einfach apt upgrade tippen kann, sondern warten muss, bis das Docker-Team das Basis-Image neu baut und danach das WordPress-Image darauf aufsetzt. Das php:8.3-apache-Image kam gegen 19:24 Uhr, das WordPress-Image gegen 20:40 Uhr, und um 20:48 Uhr lief bitpage.de auf PHP 8.3.36. Das waren also rund fünf Stunden nach dem Release, in denen die Seite angreifbar war, und seit dem Leak am Montag knapp zwei Tage. Dasselbe Spiel bei Matomo, das auf 8.4.27 ging.
# altes Image sichern, neues ziehen, Container neu erstellen
docker tag wordpress:php8.3-apache wordpress:php8.3-apache-prev-20261021
docker pull wordpress:php8.3-apache
docker compose up -d   # bzw. docker rm + docker run mit den alten Parametern

# prüfen
docker exec wp_bitpage php -v
PHP 8.3.36 (cli) (built: Oct 21 2026 15:57:18) (NTS)
Ich muss ehrlich sein: In den fünf Stunden habe ich keinen der Workarounds eingebaut, sondern darauf gesetzt, dass Wordfence und die schiere Zahl der nötigen Requests reichen, und das war mehr Hoffnung als Plan. Danach habe ich zumindest nachgeschaut, ob jemand in der Zeit etwas versucht hat. Die Logs des vorgeschalteten nginx-Proxys zeigen für den 19. bis 21. Oktober keinen einzigen abgewiesenen Upload, keine Häufung von 500er-Fehlern außer den üblichen Scannern, die wp-settings.php direkt aufrufen, und keine Requests mit den Mustern, die Wiz als Indikatoren nennt. In wp-content/uploads liegt keine fremde PHP-Datei, und Wordfence hat seit Montag 47 Requests geblockt, alles Routine wie Directory Traversal und bekannte Bot-Kennungen. Was ich dagegen gelernt habe: Beim Neuerstellen des Containers ist das Apache-Log von WordPress weg, und genau da hätten die „Allowed memory size exhausted“-Meldungen gestanden, die einen Angriffsversuch verraten. Wer Docker nutzt, sollte die Logs also außerhalb des Containers sammeln, bevor der nächste Vorfall kommt.
Was Ihr jetzt tun müsst
Das Wichtigste zuerst: Ein WordPress-Update, ein Plugin-Update oder ein Theme-Update hilft hier überhaupt nicht, weil die Lücke in der PHP-Laufzeit steckt. Wordfence weist darauf hin, dass die automatischen Updates von WordPress diesen Fix nicht einspielen können, und Patchstack warnt ausdrücklich vor den „Fix-Plugins“ und Code-Schnipseln, die gerade in Foren kursieren, weil sie nichts beheben und die Seite beschädigen können. Also:
- Version prüfen. Auf einem eigenen Server
php -vbzw.docker exec <container> php -v, bei einem Hosting-Paket im Kundenmenü oder perphpinfo(). Sicher seid Ihr ab 8.5.12, 8.4.27, 8.3.36 oder 8.2.35. Bei Distributionspaketen gilt stattdessen die Paketversion: Debian 13 hat den Fix in php8.4 8.4.27-1~deb13u1, Debian 12 in php8.2 8.2.35-1~deb12u1, Ubuntu 24.04 in php8.3 8.3.6-0ubuntu0.24.04.13, Ubuntu 22.04 in php8.1 8.1.2-1ubuntu2.28. Nach dem Paket-Update unbedingt PHP-FPM bzw. Apache neu starten, sonst läuft der alte Code weiter. - Beim Hoster nachsehen. Statusseite prüfen, im Zweifel beim Support nachfragen, ob der Fix installiert ist, nicht nur geplant. Eine unveränderte Versionsnummer heißt nicht automatisch ungepatcht, eine alte Nummer wie 8.4.24 ohne Hoster-Zusatz ist aber ein schlechtes Zeichen.
- Docker und Appliances. Images neu ziehen und Container neu erstellen, bei abgeleiteten Images wie Nextcloud oder Matomo darauf achten, dass auch die ihr Basis-Image schon bekommen haben. Dazu alles, was eine PHP-Oberfläche mitbringt: Nextcloud, NAS von Synology und QNAP, pfSense und OPNsense, Firewalls von Palo Alto, Router-Oberflächen. Dort hilft nur ein Firmware-Update des Herstellers, bis dahin die Oberfläche nicht ins Internet hängen.
- PHP 8.1 und älter. Dafür gibt es keine offiziellen Releases mehr. Entweder die Distribution liefert einen Backport, oder Ihr nehmt die Pakete von Ondřej Surý, oder Ihr nutzt den Anlass für den Sprung auf 8.3 oder 8.4. Wer das nicht sofort kann, sollte die Seite laut WordPress.org, CISA und NCSC bis dahin offline nehmen.
- Workarounds nur als Notnagel. Wenn Ihr wirklich nicht patchen könnt, reduzieren die folgenden Einstellungen die Angriffsfläche, aber das PHP-Team sagt ausdrücklich, dass sie eine Installation nicht sicher machen. Sie gehören in die php.ini, den FPM-Pool oder die Apache-Konfiguration, nicht in
ini_set()oder eine.user.ini, und danach müssen alle Worker neu gestartet werden. Bei PHP-FPM hilft zusätzlichpm.max_requests=1, bei Nginx oder einem Proxy davor das Blockieren von Multipart-Uploads, wie es CERT-FR und einige Hoster vorübergehend gemacht haben.
; CVE-2026-109618
memory_limit = -1            ; per php_admin_value, damit es niemand überschreibt
post_max_size = 8M           ; ohne Datei-Uploads, mit Uploads 32M
upload_max_filesize = 8M     ; muss kleiner als post_max_size bleiben

; CVE-2026-109619
session.upload_progress.enabled = 0
fatal_error_backtraces = 0   ; nur PHP 8.5
Und wenn der Patch drauf ist, ist die Arbeit nicht vorbei, denn, um das BACS noch einmal zu zitieren, „ein Update beseitigt keine bereits erfolgte Kompromittierung“. Schaut in die Logs nach ungewöhnlichen Multipart-POSTs, auf die kurz darauf „Allowed memory size exhausted“-Fehler oder Serien von HTTP 500 folgen, nach auffällig großen PHPSESSID-Cookies in den Antworten und nach PHP-Workern, die sich ständig neu starten oder, wie die CISA es formuliert, plötzlich Shells starten und Werkzeuge nachladen. Sucht mit find /var/www -name '*.php' -newermt '2026-10-20' nach PHP-Dateien, die seit Montag neu sind, besonders unter wp-content/uploads, und lasst Wordfence oder einen vergleichbaren Scanner einmal komplett durchlaufen. Wer Snort oder Suricata betreibt, bekommt von Cisco Talos die Regeln 67359 und 67360 im Community-Ruleset. Und weil die Lücken auch Speicherinhalte preisgeben können, rät Patchstack bei jedem Verdacht dazu, Zugangsdaten und API-Schlüssel zu tauschen. Findet Ihr etwas, gilt die übliche Reihenfolge: Seite offline, Backup von vor dem Leak zurückspielen, alle Passwörter, Schlüssel und Salts erneuern.
Fazit
Ich habe in über zehn Jahren Bloggen keinen Tag erlebt, an dem so viele Behörden, Kliniken, Universitäten und Hoster gleichzeitig freiwillig den Stecker gezogen haben, von der Berliner Internetwache über die finnische Regierung bis zu Final Fantasy, und ich finde, sie hatten recht damit. Wenn das PHP-Team selbst sagt, dass es keinen vollständigen Workaround gibt, und das BSI mit Ausnutzung binnen Stunden rechnet, ist eine Wartungsseite für ein paar Stunden das kleinere Übel gegenüber einer Webshell auf dem Server. Bemerkenswert finde ich drei Dinge: dass ein Fehler, der seit Jahrzehnten im Code steckt und 2024 schon einmal angeklopft hatte, erst durch KI-Modelle zu einem praktikablen Exploit wurde, dass die PHP Foundation ihr eigenes Versagen so offen benennt und um Geld bittet, obwohl zwei Drittel des Webs auf ihrer Arbeit laufen, und dass die Lücke nicht an WordPress, Joomla oder irgendeinem Plugin hängt, sondern an der Sprache selbst, sodass die ganze Kette von der Distribution über den Hoster bis zum Docker-Image durchlaufen muss, bevor eine einzelne Seite wieder sicher ist. Bei mir hat das fünf Stunden gedauert, und das war schon mit ständigem Nachschauen.
Daher mein Rat: Prüft heute noch Eure PHP-Version bzw. den Status Eures Hosters, nehmt Seiten mit PHP 8.1 oder älter ernsthaft vom Netz, bis Ihr einen Backport oder eine neue Version habt, schottet Web-Oberflächen von Firewalls und NAS-Geräten ab und schaut nach dem Patch einmal in die Logs. Und wer wie ich Docker nutzt, sollte die Logs ab sofort außerhalb der Container aufheben.
Wie war es bei Euch? Welcher Hoster war schnell, bei welchem hing Eure Seite den ganzen Abend in der Wartung, und habt Ihr in Euren Logs Angriffsversuche gefunden? Schreibt es mir in die Kommentare, ich aktualisiere die Hoster-Tabelle gern, sobald sich etwas tut.
Quellen
- PHP: Critical remote code execution vulnerabilities, update now mit den offiziellen Workarounds, dazu die Advisories GHSA-w8hw-w9fx-j79w und GHSA-6wmf-4rv5-p3rp
- PHP Foundation: Today’s PHP security release and how we’re strengthening PHP security mit der Zeitlinie seit 2024
- Wiz: PHP2Shell, AI uncovers critical RCE vulnerabilities mit der technischen Analyse und den Indikatoren
- BSI-Pressemitteilung und BSI-Sicherheitshinweis 2026-297981-1132; CISA, UK NCSC, CERT-EU 2026-018, CERT-FR, CERT.at, BACS, ENISA CNW-2026-04
- Borns IT- und Windows-Blog: php2shell mit vielen Leserberichten zu Hostern, Caschys Blog, Deskmodder, ComputerBase
- heise: php2shell, teltarif: Behörden offline, Tagesspiegel: Berliner Webseiten offline, diebayern.de, oe24, Blick, SRF
- NOS-Liveblog, Brussels Times, Yle, DR, BetaKit (Kanada), NBC News, KrebsOnSecurity mit den Censys-Zahlen, ITmedia (Japan), ABC (Australien)
- Cloudflare, Patchstack, SecurityWeek, Cisco Talos, Huntress
- Automattic, WordPress.org, Drupal PSA, Matomo, Laravel News, Nextcloud-Issue, Palo Alto Networks, Sophos, NCSC-NL: Liste betroffener Software
- Blogosphäre: ifun.de, LinuxNews.de, kernel-error.de, Sir Apfelot, Dr. Web, Alexandre Daubois: What the PHP2Shell rumors got wrong, Dead Neurons: PHP2Shell was in the training data, Josh Bowen: Patching PHP 7.4, Steve Grunwell, openai/php2shell-checker, Hacker-News-Thread, Torsten Landsiedel auf Mastodon
- Wikitech: Incidents/2026-10-21 PHP security update und Diff: Impact of PHP vulnerabilities on Wikimedia tools
- Statusseiten von netcup, Mittwald, Hetzner, IONOS, Profihost, manitu, Timme Hosting, DomainFactory, Infomaniak
- Debian Security Tracker, Ubuntu CVE-Tracker, W3Techs: PHP-Verbreitung, Wikipedia: PHP2Shell
Beitragsbild: Tim Mossholder auf Unsplash. Die Screenshots der Status-, Wartungs- und Mastodon-Seiten habe ich am 21. Oktober 2026 zwischen 21:00 und 22:30 Uhr selbst angefertigt.